新手学电脑,请多多指教。
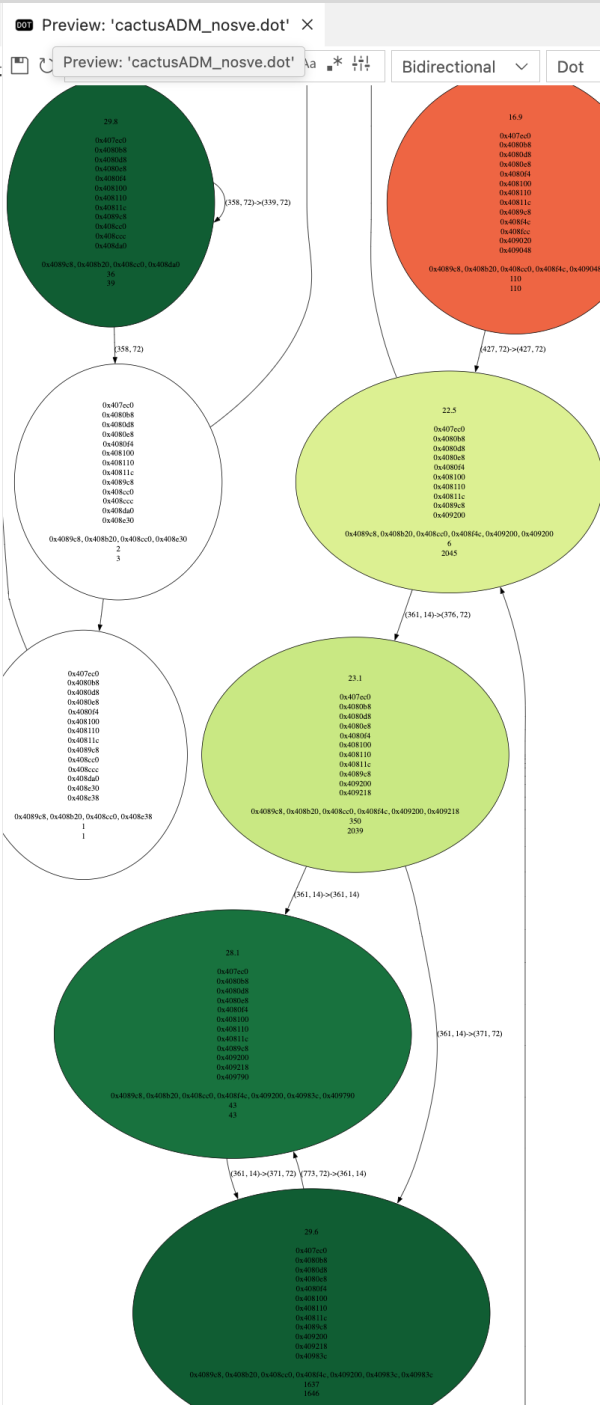
Can we trust the cpu cycles from LLVM-MCA?
Background Recently, I've been delving into the ARM SVE2 speed-up over pure NEON in common workloads that are…
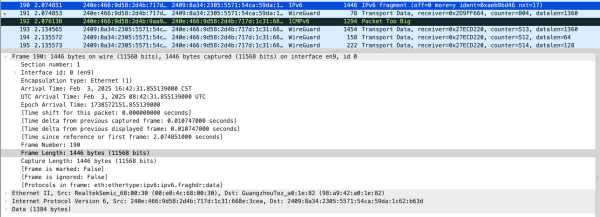
网络设备(特指 TP-Link)距离正确处理 IPv6 Fragmentation 还有多远
背景 过年在外婆家住了几天,因为这里没有装宽带于是带上了 5G CPE ,以及随便购买了 TP-Link 7DR3630 路由器(现已退货换其他产品) ,为几天后外婆家安装宽带做好准备。由于我的大部分工作数据放在家里的服务器上,出于习惯一般喜欢连接 WireGuard VPN 回家。而连接公共 WiFi 时我一般习惯加上默认路由到 VPN ,结果今天回到外婆家里连着 5G CPE…
How CCMP reduce the pressure of branch predictor on aarch64
Preface When comparing branch MPKI (Miss Per Kilo Instructions) on aarch64 with other architectures such as RISC-V (including…
"Short-leg" of RISC-V | RISC-V 的小短腿
Preface I came across some code performance issues only on RISC-V recently. Their root cause is the short…
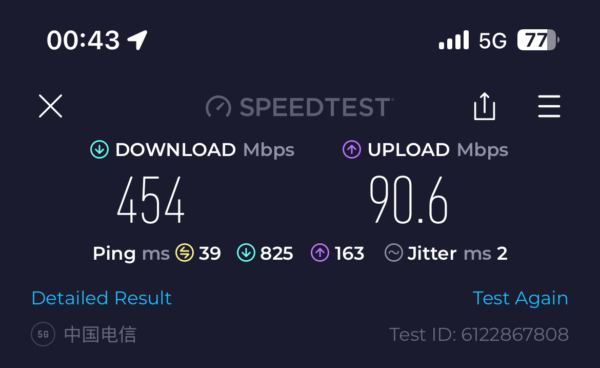
在 5G NR 时代,我们真的该大规模部署 TCP BBR 了
背景 自从 Speedtest.net 在 2 年前增加了下载与上传时的 ping 测试后,我们往往会在 LTE / 5G 上观测到其下载和上传占满空口带宽后出现了延迟大幅飙升的情况,而这一情况在使用 WiFi 时影响非常小,但在使用基于 10G EPON / XGPON的有线ISP(有限速)中几乎不存在。这就导致我们使用…
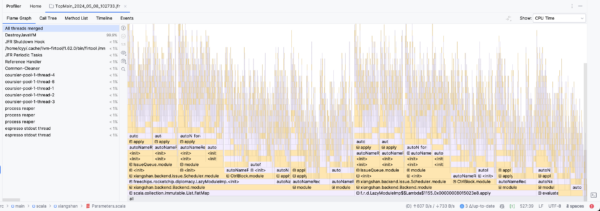
Chisel编译时间优化实例——将香山的双核RTL生成时间从36分钟压缩到7分钟
背景 自从香山新后端合并后, Chisel 编译时间大幅增加,特别是在双核的 DefaultConfig 下,在我的 13900K 机器 + OpenJDK 11 的条件下, FIR 的生成时间已经达到的 34 分钟,具体可以见该 issue ,而在之前,…
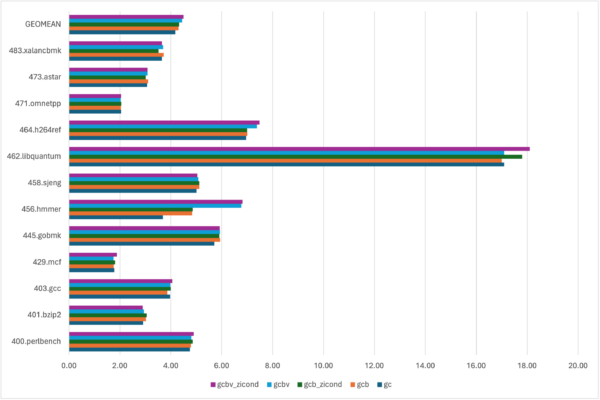
Spacemit X60 (K1) SPECINT 2006 Benchmark
I ordered a BananaPi F3 last week and it arrived on May 6th. Using the opensbi and kernel…
T-HEAD C910 SPEC CPU Benchmark
Enviroment Board: Lichee Module 4A (2GHz Version) SBI: revyos/opensbi/th1520-v1.3.1 Kernel: revyos/th1520-linux-kernel/th1520-master-wip SBI and Kernel Compiled with riscv64-linux-gnu-gcc version…
让树莓派4 WireGuard 性能从 400Mbps 飞涨到 1Gbps
背景 由于学校机房依然需要网络认证,因此我采用了使用 WireGuard 从别处接入网络的方式。为了评估放在学校机房的软路由需要什么样的性能才足够跑满千兆大包 WireGuard ,上周末写了个 WireGuard Benchmark 脚本 来评估 CPU 以及 Kernel 网络栈处理 WireGuard 的性能。为了方便评估以取得更多的结果,我采用 network namspace…
从与 AMBA AXI 的对比学习 TileLink
Background 最近仔细学习了一下 TileLink 以及 TL-C 的一致性协议,希望写一篇文章给 有AMBA AXI基础 的读者提供一篇 TileLink 快速入门的介绍。 本文参考的 TileLink Spec 基于https://starfivetech.com/uploads/tilelink_spec_1.8.1.pdf Variant Protocol Narrow…
Intel Data Dependent Prefetcher 对 SPEC CPU 2017 的影响
背景 最近在做一些商业硬件的 Data Dependent Prefetcher 测量,无意中注意到 Intel 13 代酷睿是有 Data Dependent Prefetcher 的,因此先进行了一个简单的尝试。 介绍与开关控制 介绍可以参考 Intel的文档 。 而根据…
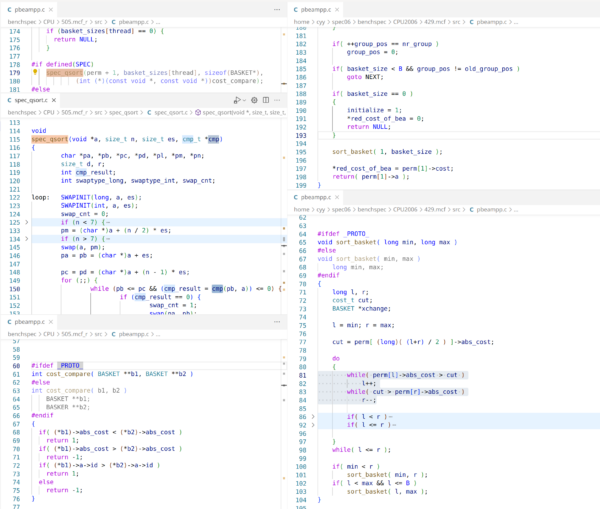
SPEC CPU 2017 mcf 与 2006 的差异浅析
背景 最近朋友 Easton Man 告诉了我一些SPEC CPU 2006 与 2017 的一些性能计数器 Topdown 统计结果,在观测他的结果后我惊讶地发现,SPEC CPU 2017中 mcf 这一 workload 对…
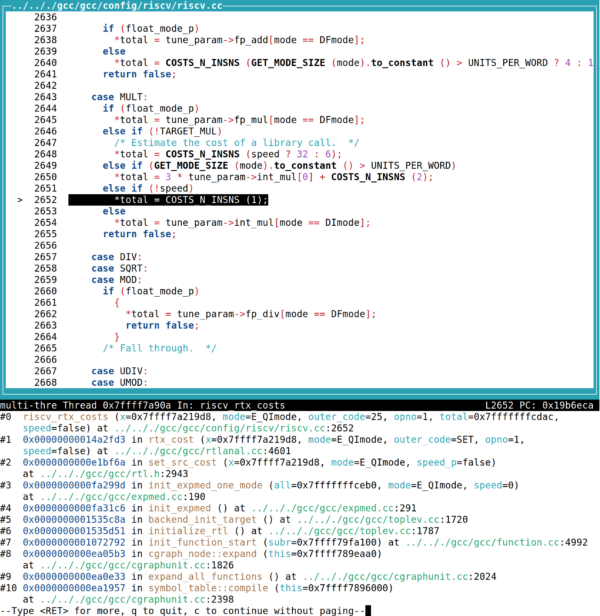
从CPU RTL到GCC expmed Cost Model
背景 最近和朋友讨论一个编码算法的问题的时候意外发现,当前 RISC-V 的 GCC 即使使用-O3优化的情况下,也不会将 divide by const 优化为Barrett reduction。但我测试了默认参数的 x86 、 aarch64 、 mips32 ,均存在该优化。且通常来说, CPU…
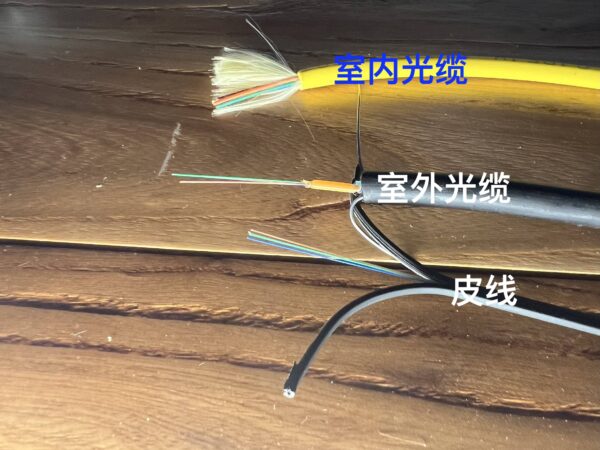
自己家的全屋光纤与无线覆盖布网实战
原则与实战结果 自己家今年搬入了新居,对于我来说一件十分重要的事情就是规划网络布线了。 我计划按照以下原则布置网络: 每个房间都有 4 芯光纤,确保以太网使用 2 芯之后还有 2 芯可用,从而可以接 HDMI 光端机等设备以及出现断芯等情况后可以替换。 有人活动的位置 5GHz WiFi RSSI <= -65…
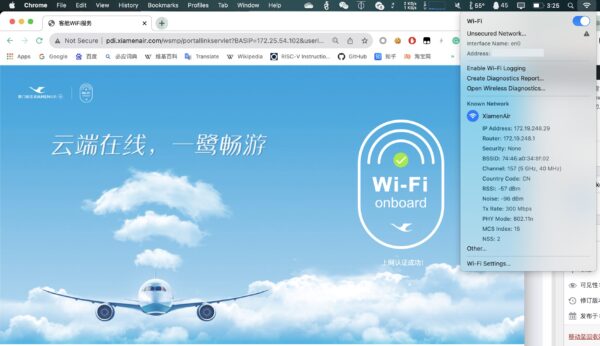
第一次在国内航班体验机上WiFi
于 2023 年 8 月 3 日乘坐了厦门航空的 MF8208 从西安飞往厦门,执飞飞机是一架 BOEING 787-8 宽体型客机,上飞机后惊奇地发现座位旁有 WiFi 图标,而在地面上我拿手机搜索了一圈并没有看到任何非个人热点的 SSID 。但我依然非常期待,因为距离上一次在空中上网已经是2014年在美国使用 gogoinflight 了。…
尝试Xilinx FPGA上的BUFGCE
最近在学习 Firesim ,其中对我自己科研很重要的一个功能便是 FASED 提供了 Memory Timing Model 的模拟。因为之前和别人合作论文曾被审稿人提出过 100MHz FPGA 使用 1600MHz 的内存,使得内存的延迟非常低,其性能表现像是一个大的 LLC Cache 而不是真实的内存,导致访存性能与真实 ASIC…
浅谈早期 Fault Tolerance 虚拟机原理
背景 最近遇到了一些灵车硬件损坏问题,包括自己的台式机 13900K CPU 突然死机后重启就出现 CPU soft lockup,再重启直接无法点亮;自己的旧台式机出现 Correctable ECC 报错(感谢AMD消费级CPU也部分支持ECC);以及一台别人的服务器上解压tar.gz包出现了CRC错误。一周内的这些经历使我开始思考云计算场景如何Tolerance这些奇怪的硬件损坏问题,于是看到了一篇VMWare vSphere 4(2010)年代的论文——The Design of a Practical System…
第一次给Kernel邮件列表交Patch遇到的小坑
第一次交 PATCH ,交成了这样: 而我交 patch 的方式只不过是: git format-patch 457391b0380335d5e9a5babdec90ac53928b23b4 –cover-letter # edit cover letter git send-email \ –from…
DDR4与HBM在UltraScale+ HBM上的IOPS测试
最近一个科研 idea 需要 measure 一些内存器件的 latency 数据,因此用 FPGA 对主流的内存器件的访问 Latency 进行了一个调研,诚然这样的结果和 FPGA 上具体 Memory Controller 的 IP 实现有关,但也可以作为一个参考,相信…
让Thunderbolt可以使用更大的BAR
问题描述 在Xilinx 7-Series FPGA上用AXI Memory Mapped to PCI Express IP核设置了一个256M的BAR,这个BAR直接连接到主板的PCIe上可以正常进行MMIO,但将FPGA通过Thunderbolt硬盘盒+M.2转PCIe连接到Thunderbolt上却无法使用。 通过查阅dmesg可观测到如下报错信息: [ 246.677146] pci 0000:0c:00.0: BAR 0: no…
Augury: Using Data Memory-Dependent Prefetchers to Leak Data at Rest 阅读笔记
概述 这是一篇发表在 Oakland'22 ( aka IEEE S&P ) 的文章,讲的是在 Apple M1 上发现了前所未有的 Data Memory-Dependent Prefetcher (下称 DMP ),该预取器也带来了前所未有的侧信道攻击。作者对…
sPIN: High-performance streaming Processing in the Network 阅读笔记
这是一篇来自 SCPL@ETHZ 组在 SC'17 上的一篇文章。主要想法是在 RDMA 网卡上加入一个处理器用来 Offloading 一部分数据移动任务,并在 LogGOPSim 与 gem5 上进行了实验。 原文链接 Motivation 当前高能效处理器组成的高度可扩展的系统发展带来了总线互联的压力。例如在 400Gbps 的网络中,一个…
Draco(MICRO'20) Architectural and Operating System Support for System Call Security 阅读笔记
要解决的问题 Linux内核提供了seccomp来对syscall权限进行检查,被广泛应用在容器、沙盒等多种场景,例如Docker和Android。但原版seccomp的实现是通过BPF对定义的规则一条条进行检查,如下图所示,十分低效: 同时,作者也进行了一系列的benchmark发现这样的检查带来了较大的开销: 其中,左边的docker-default指的是Docker默认使用的seccomp-profile,syscall-noargs指的是使application-specific profile但只检查syscall id而不检查参数,而syscall-complete就在noargs的基础上加上参数检查,最后加上-2x的后缀表示的是这些检查复制2次,来建模更复杂的安全检查场景。 可以看出,seccomp检查带来的开销即使是对于像nginx这样的macro-benchmarks也是比较大的,但现有的seccomp使用BPF,规则十分灵活,因此需要针对这种灵活的规则设计一种加速的方法。 Observation 检查系统调用ID会给Docker容器中的应用带来明显(noticeable)的性能开销。 检查系统调用参数比只检查系统调用ID的开销大得多(significantly more expensive)。 规则加倍,开销加倍。 syscall with 相同id和参数存在局部性(下图指明了实验中的距离) 解决方法 为了解决这个问题,作者引入了一个Fast…
聊聊内存序
最近读完了 A Primer on Memory Consistency and Cache Coherence这本书,写一篇文章结合我个人了解的其他知识总结一下内存序。 文章假定读者学习了基本的体系结构。 概念 Cache Coherence 相信大家对Cache有一个基本的理解。但这里需要引出一个新的概念,共享内存中的Private Cache。 即使是简单的单核处理器,往往L1 I-Cache与D-Cache也是Private的。因为IFU(取指单元)与LSU(访存单元)通常分布在处理器流水线的不同阶段,它们可能需要同时访问。既然是Private,这个时候如果我们通过访存指令写入了一些指令(通过D-Cache)到某个内存地址,而这个地址已经在I-Cache中,结果就在取指时有可能取到旧值,如何解决这一问题? 也许L1…
Back to Top