Background In my previous post I argued that a C++ reference can be faster than a pointer, because…
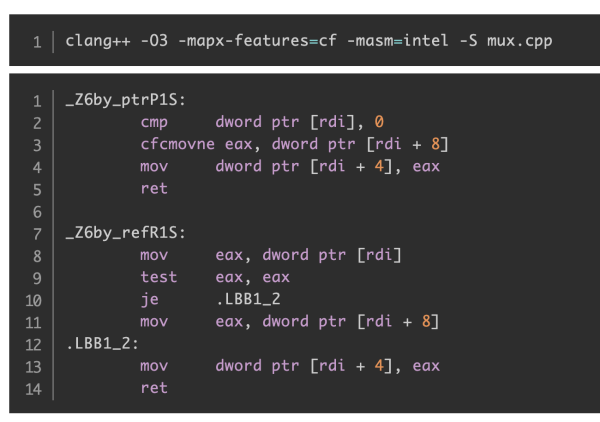
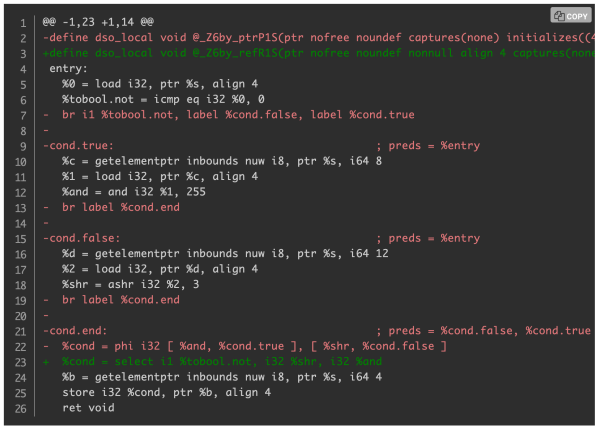
Why reference is faster than pointer, How ISA improve this
Background Two years ago, I submitted Verilator PR #5254 to replace the pointer to the huge model struct…
好奇宝宝在这个时代如何跟着 AI 学习
背景 最近在家里给 Broadwell 老机器(5代酷睿)+ 华硕 Z97 主板插上了一张 NVIDIA V100 32G 显卡。BIOS 给 PCIe RC 分配的 64-bit Prefetchable BAR…
LLM 新人的压榨本地 DeepSeek V4 Flash 推理记
0. 背景 最近 DeepSeek-V4-Flash-0731 模型能力的提升令人瞩目,刚好自己有一台 AMD Strix Halo, 于是就想看看在这台统一内存的 APU 上能跑多快。因此,我跟着 Fable-5 学习了一些 LLM 的基础知识,让 AI 帮我进行了一些优化实验,最终把 batch-1…
RISC-V 通用处理器,未来在哪呢
前言 相信大家也看到了,RISC-V 通用处理器生态圈的现状并不太平。 它市场竞争力低吗?确实! 我们能改变吗?我相信还有机会! 注:本文仅代表本人立场与观点,不代表任何组织、开源社区。 现状是什么样呢? 基础的 Linux 内核、发行版以及大量的开源软件支持 QEMU 级别单核性能的现存硬件 碎片化的 ISA 遇上想建立新纪元的发行版 满足 Bug-free &&…
Is TSO a historical burden for modern CPU? Case study on Apple M1
Is TSO a historical burden for modern CPU? Preface x86-TSO (Total Store Order) is the memory consistency model…
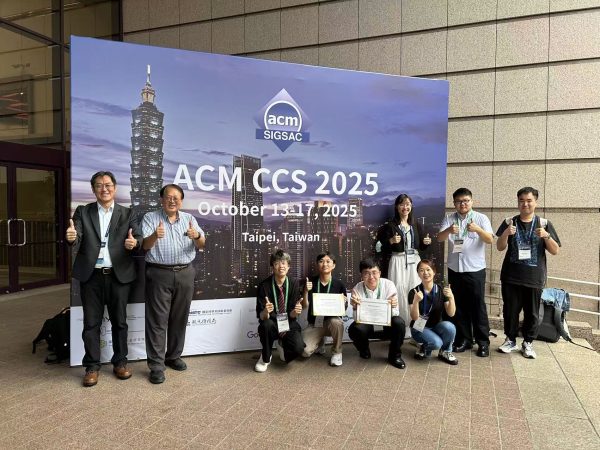
CCS 2025 Travel Notes
Preface I recently traveled to Taipei for the ACM CCS 2025. It's been 14 years since my last…
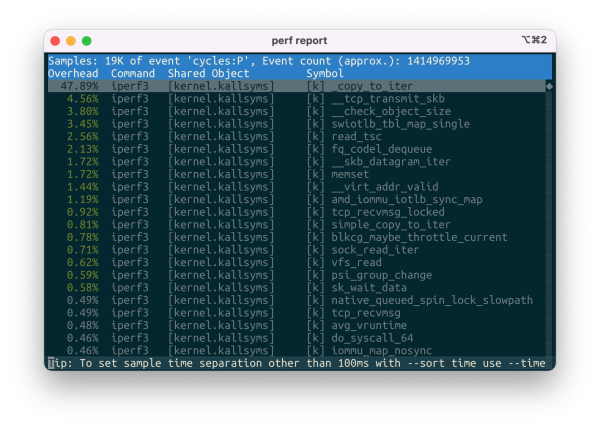
惊人的 IOMMU Overhead 与不合理的 AQC 网卡驱动
背景 给家里的 AMD AI MAX 395 小主机加了个 Thunderbolt 万兆网卡,期望给这台小主机通上 10Gbps 的信息高速公路,这样我可以利用家里的 NAS 的大容量存储快速拉 LLM ,网卡用的是几年前买给 Mac 用的 QNAP…
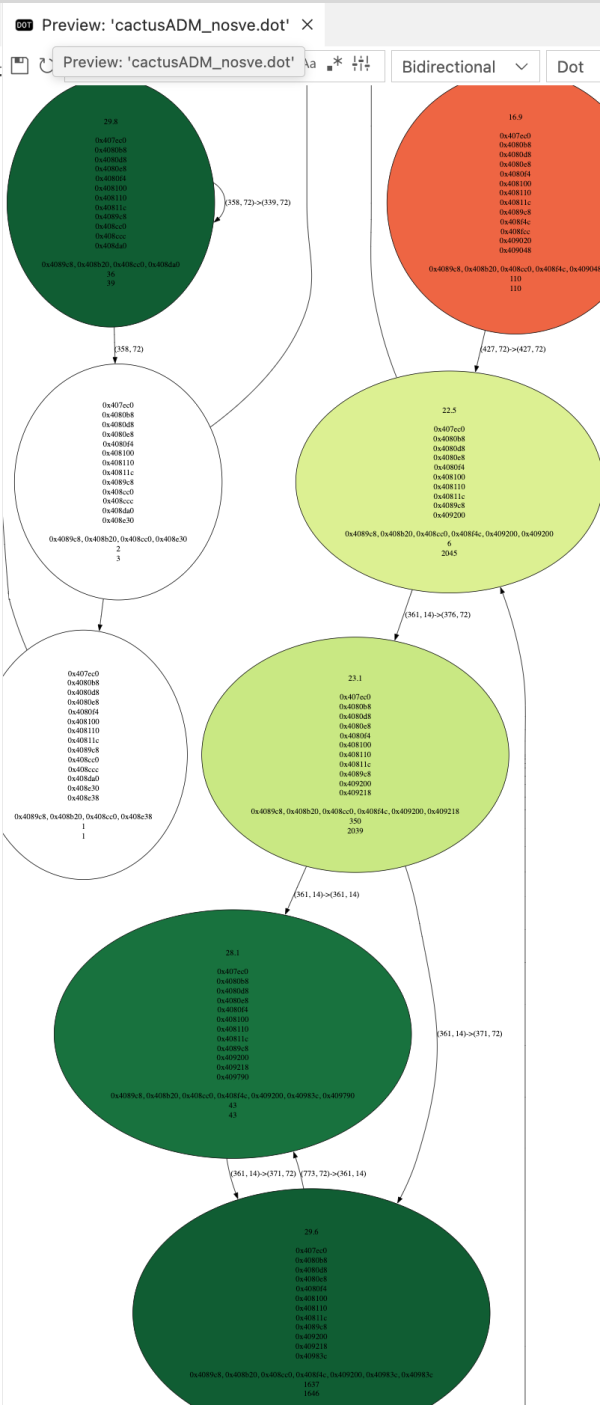
Can we trust the cpu cycles from LLVM-MCA?
Background Recently, I've been delving into the ARM SVE2 speed-up over pure NEON in common workloads that are…
How CCMP reduce the pressure of branch predictor on aarch64
Preface When comparing branch MPKI (Miss Per Kilo Instructions) on aarch64 with other architectures such as RISC-V (including…
"Short-leg" of RISC-V | RISC-V 的小短腿
Preface I came across some code performance issues only on RISC-V recently. Their root cause is the short…
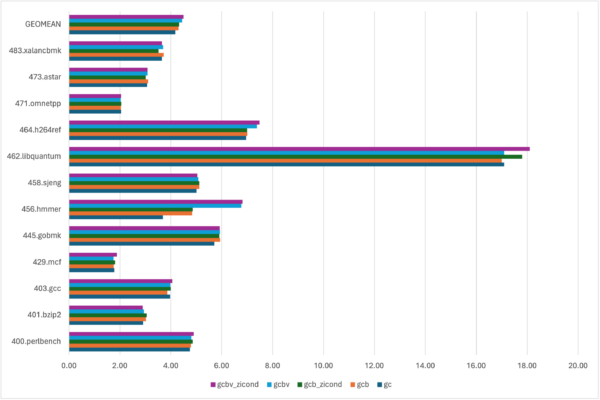
Spacemit X60 (K1) SPECINT 2006 Benchmark
I ordered a BananaPi F3 last week and it arrived on May 6th. Using the opensbi and kernel…
T-HEAD C910 SPEC CPU Benchmark
Enviroment Board: Lichee Module 4A (2GHz Version) SBI: revyos/opensbi/th1520-v1.3.1 Kernel: revyos/th1520-linux-kernel/th1520-master-wip SBI and Kernel Compiled with riscv64-linux-gnu-gcc version…
从与 AMBA AXI 的对比学习 TileLink
Background 最近仔细学习了一下 TileLink 以及 TL-C 的一致性协议,希望写一篇文章给 有AMBA AXI基础 的读者提供一篇 TileLink 快速入门的介绍。 本文参考的 TileLink Spec 基于https://starfivetech.com/uploads/tilelink_spec_1.8.1.pdf Variant Protocol Narrow…
Intel Data Dependent Prefetcher 对 SPEC CPU 2017 的影响
背景 最近在做一些商业硬件的 Data Dependent Prefetcher 测量,无意中注意到 Intel 13 代酷睿是有 Data Dependent Prefetcher 的,因此先进行了一个简单的尝试。 介绍与开关控制 介绍可以参考 Intel的文档 。 而根据…
SPEC CPU 2017 mcf 与 2006 的差异浅析
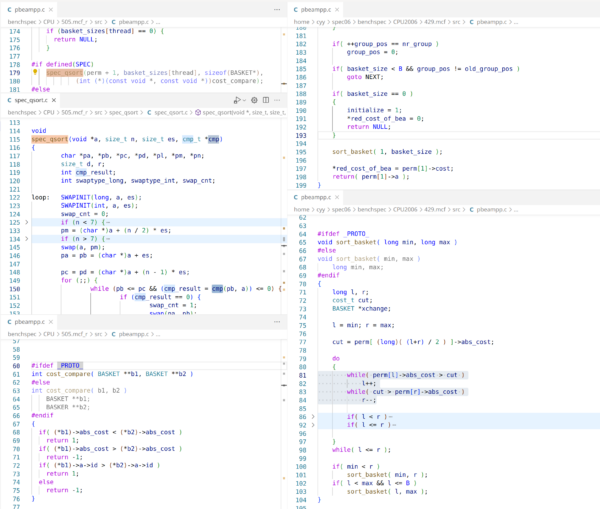
背景 最近朋友 Easton Man 告诉了我一些SPEC CPU 2006 与 2017 的一些性能计数器 Topdown 统计结果,在观测他的结果后我惊讶地发现,SPEC CPU 2017中 mcf 这一 workload 对…
尝试Xilinx FPGA上的BUFGCE
最近在学习 Firesim ,其中对我自己科研很重要的一个功能便是 FASED 提供了 Memory Timing Model 的模拟。因为之前和别人合作论文曾被审稿人提出过 100MHz FPGA 使用 1600MHz 的内存,使得内存的延迟非常低,其性能表现像是一个大的 LLC Cache 而不是真实的内存,导致访存性能与真实 ASIC…
浅谈早期 Fault Tolerance 虚拟机原理
背景 最近遇到了一些灵车硬件损坏问题,包括自己的台式机 13900K CPU 突然死机后重启就出现 CPU soft lockup,再重启直接无法点亮;自己的旧台式机出现 Correctable ECC 报错(感谢AMD消费级CPU也部分支持ECC);以及一台别人的服务器上解压tar.gz包出现了CRC错误。一周内的这些经历使我开始思考云计算场景如何Tolerance这些奇怪的硬件损坏问题,于是看到了一篇VMWare vSphere 4(2010)年代的论文——The Design of a Practical System…
DDR4与HBM在UltraScale+ HBM上的IOPS测试
最近一个科研 idea 需要 measure 一些内存器件的 latency 数据,因此用 FPGA 对主流的内存器件的访问 Latency 进行了一个调研,诚然这样的结果和 FPGA 上具体 Memory Controller 的 IP 实现有关,但也可以作为一个参考,相信…
Augury: Using Data Memory-Dependent Prefetchers to Leak Data at Rest 阅读笔记
概述 这是一篇发表在 Oakland'22 ( aka IEEE S&P ) 的文章,讲的是在 Apple M1 上发现了前所未有的 Data Memory-Dependent Prefetcher (下称 DMP ),该预取器也带来了前所未有的侧信道攻击。作者对…
sPIN: High-performance streaming Processing in the Network 阅读笔记
这是一篇来自 SCPL@ETHZ 组在 SC'17 上的一篇文章。主要想法是在 RDMA 网卡上加入一个处理器用来 Offloading 一部分数据移动任务,并在 LogGOPSim 与 gem5 上进行了实验。 原文链接 Motivation 当前高能效处理器组成的高度可扩展的系统发展带来了总线互联的压力。例如在 400Gbps 的网络中,一个…
Draco(MICRO'20) Architectural and Operating System Support for System Call Security 阅读笔记
要解决的问题 Linux内核提供了seccomp来对syscall权限进行检查,被广泛应用在容器、沙盒等多种场景,例如Docker和Android。但原版seccomp的实现是通过BPF对定义的规则一条条进行检查,如下图所示,十分低效: 同时,作者也进行了一系列的benchmark发现这样的检查带来了较大的开销: 其中,左边的docker-default指的是Docker默认使用的seccomp-profile,syscall-noargs指的是使application-specific profile但只检查syscall id而不检查参数,而syscall-complete就在noargs的基础上加上参数检查,最后加上-2x的后缀表示的是这些检查复制2次,来建模更复杂的安全检查场景。 可以看出,seccomp检查带来的开销即使是对于像nginx这样的macro-benchmarks也是比较大的,但现有的seccomp使用BPF,规则十分灵活,因此需要针对这种灵活的规则设计一种加速的方法。 Observation 检查系统调用ID会给Docker容器中的应用带来明显(noticeable)的性能开销。 检查系统调用参数比只检查系统调用ID的开销大得多(significantly more expensive)。 规则加倍,开销加倍。 syscall with 相同id和参数存在局部性(下图指明了实验中的距离) 解决方法 为了解决这个问题,作者引入了一个Fast…
聊聊内存序
最近读完了 A Primer on Memory Consistency and Cache Coherence这本书,写一篇文章结合我个人了解的其他知识总结一下内存序。 文章假定读者学习了基本的体系结构。 概念 Cache Coherence 相信大家对Cache有一个基本的理解。但这里需要引出一个新的概念,共享内存中的Private Cache。 即使是简单的单核处理器,往往L1 I-Cache与D-Cache也是Private的。因为IFU(取指单元)与LSU(访存单元)通常分布在处理器流水线的不同阶段,它们可能需要同时访问。既然是Private,这个时候如果我们通过访存指令写入了一些指令(通过D-Cache)到某个内存地址,而这个地址已经在I-Cache中,结果就在取指时有可能取到旧值,如何解决这一问题? 也许L1…
在Xilinx FPGA上搭建SoC
背景 之前出于科研需求和龙芯杯比赛需求都自己搭建过SoC来运行CPU软核,整理一下我的搭建SoC的流程。以下的讨论基于MIPS和RISC-V两种软核ISA为例。 大家也可以参考我搭建的两个SoC以及对应的软件: cyysoc (RISC-V Rocket+Coherent DMA) pblaze_soc 某大船SSD上的xc7k325t-2 FPGA+2G 72bit DDR3 ECC 用了某个PCI-E引出到SFP接口的扩展板,连接光模块/电口模块提供网络 PCI-E和SFP的IO在FPGA上都是GTX 用了某个该板子的IO接口转USB UART的扩展板 扩展板上面还有rgmii…
Back to Top