云端 AI 与隐私,我可以全都要吗?
背景
最近,我给手机升级了 iOS 27, macOS 也升级了 macOS 27,观测到 Siri AI 和以前的 Apple Intelligence 大不一样了。
首先,我非常喜欢它的新交互方式,直接从 iPhone 的灵动岛下拉,就可以就着当前屏幕上的内容询问 AI。当你遇到需要输入的场景,也可以随时唤起 Write with Siri,使得 AI 交互变得更加自然和高效,已经可以渗透到这些设备使用的各个环节。
而且,功能上也有了很大的提升。它的端侧 Agent 能力终于进步到了可以结合我的本地数据,包括联系人、日历、备忘录、邮件、iMessage 等,也可以联网查询大量的在线信息,从而提供更加智能和个性化的服务。
P.S. 这个功能至今没有对中国大陆销售的 Apple 设备开放,我的 iPhone 和 Mac 都是在香港买的。
但是,这也意味着,这些 Agent 功能在享受便利的同时,也带来了隐私和安全方面的挑战。我们越来越多的数据被发送给 AI 处理。而一旦这些数据要面临上云,而云上的存储又并非像 iCloud 的 Advanced Data Protection 那样由端侧加密,即使我对云端有足够的信任,但在 AI 随时都能挖出一个 0day CVE 漏洞的情况下,谁能保证会不会哪天一觉醒来我的数据全被公开呢?更何况,一个短信发给 iPhone 打穿 Darwin 内核的漏洞即使在没有 AI 挖漏洞的年代都存在过。这种级别的漏洞利用链用于攻击个人设备,除非用于重要价值目标,否则可能是暴露代价远高于收益的行为,尚且可控。
但对于当前的我们来说,这种漏洞用于攻击 LLM 服务器,不仅可以拿到用户与 LLM 交换的数据,其中可能已经包含了大量的用户个人隐私、密钥,更有可能进一步通过用户本地的 Agent 去执行恶意的操作产生 RCE,形成对用户设备的全面控制,形成对用户隐私和安全的巨大威胁。
因此,我在过去很热衷于自己在本地搭建和使用各种 AI 工具,甚至会用两台 AMD Strix Halo 128G 跑 TP=2 推理全量 DeepSeek V4 Flash 模型,充分利用本地算力来保证数据的隐私和安全。我自己相信只有隐私问题得到充分保障,我才更愿意把更多的数据交给 AI,从而让 AI 更好地为我服务。但是最近自己玩 Apple 的 Siri AI 的时候,阅读了它的 PCC (Private Cloud Compute),发现也是另一种在云端基于 TEE (Trusted Execution Environment) 的隐私保护计算方式,因此我写下了这篇文章,想分享一下我的探索还有对云端 AI 与隐私保护的思考。
主流现状
当前的主流 AI 都是怎样对待用户隐私的?
基本全靠服务商自己的承诺,我为什么觉得承诺不可信:
- 服务器端的漏洞本身不可控,而且在现在 AI 交互记录已经成了非常有价值的数据,许多人甚至会直接把隐私、密钥放在上下文里任由 AI 处理
- 我了解到许多 Model / Model as a service / API 路由转发 公司权限管理不够规范,让大量员工可以直接访问用户的交互数据
因此,我认为这些 ToS 承诺,仅仅是一种 best effort 的保证,对于商业公司之间的知识产权等层面在我看来属于可信赖的,但对于个人隐私而言我觉得并不是一种足够安全的保障。
全同态加密(Fully Homomorphic Encryption, FHE)
如果你在 CS / Math 方向有一定的背景,可能会对同态加密的原理和应用有所了解。简单来说,同态加密允许在加密数据上直接进行计算,而无需解密。比如未来可能你的终端可以把一个密态的用户数据发送到云端,云端全程在密态完成推理,而不会看到明文数据,最终返回的结果仍然是加密的,只有终端可以解密得到明文结果。
不过很可惜的是,至今同态加密在实际应用中仍然面临着巨大的性能挑战。今年有一篇论文用 CKKS 方案在 8 张 RTX PRO 6000 上跑 Llama 3 8B 模型,得到了 18s / Token 的推理速度(注意不是 Tokens/s),因此距离实用还有很长的路要走。
Apple 怎么做?
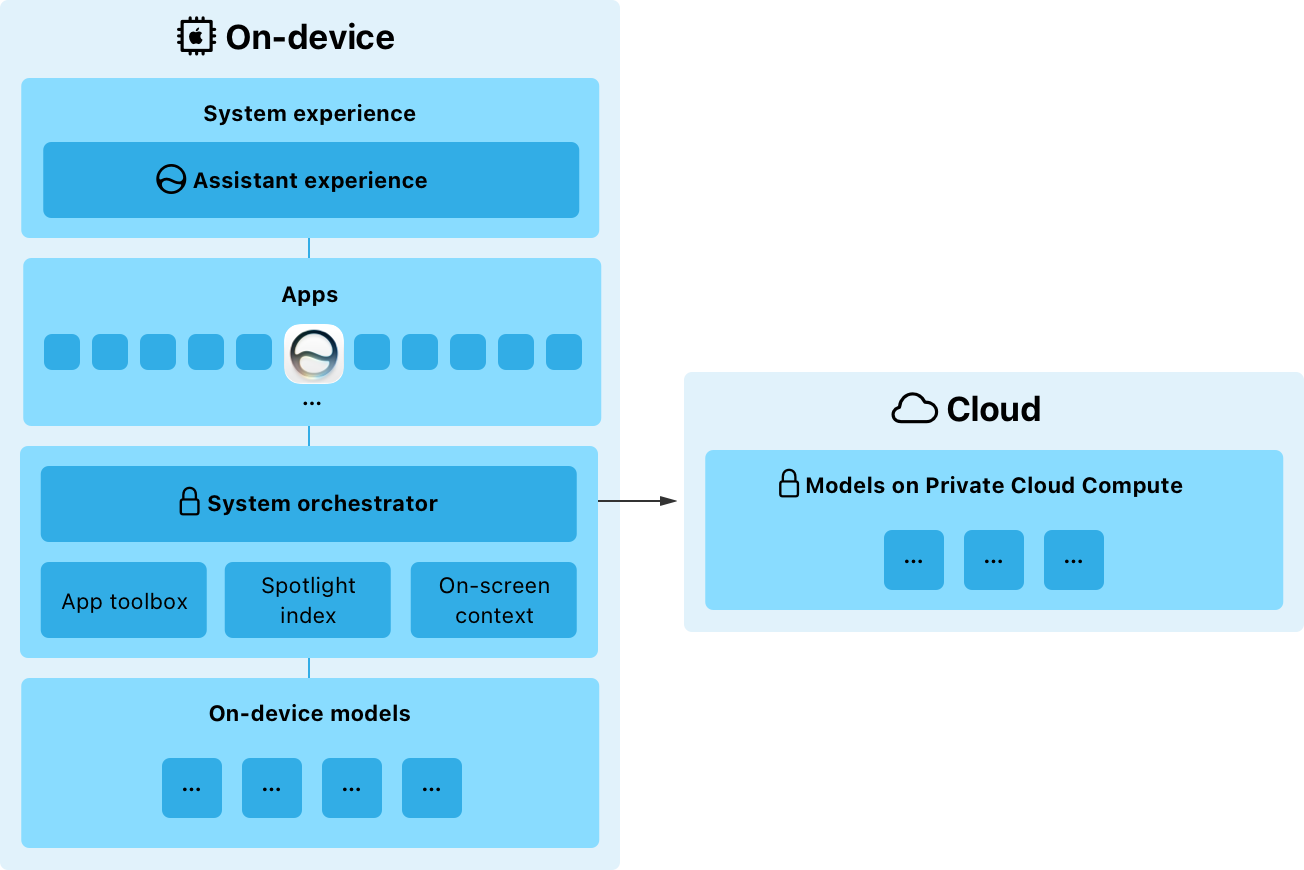
Apple Intelligence orchestration:端上的 System orchestrator 带着 App toolbox / Spotlight index / On-screen context,把请求交给 PCC 上的模型。来源:PCC Security Guide · Request Flow
Hybrid Approach
我们应该很容易想到,在端侧小模型(比如 Qwen 3.8 27B 已经有接近 Opus 4.6 的 Coding 能力,4-bit 量化版本已经可以在 48G Mac 上跑 256K 上下文)已经很强大的今天,其实完全可以作为主力模型,当遇到它处理不了的任务时,再拆分出隐私敏感的部分调用云端 Subagent 来处理。
Apple 的方案也很类似,即在端侧运行强大的 Core 模型作为主力,当遇到复杂或隐私敏感的任务时,再调用云端的 Cloud 模型处理。
AFM 3 是在 WWDC 2026 发布的 Apple 的第三代基础模型,分为 Core 和 Cloud 两大类,Core 分为 3B Dense 和 Advanced 20B Sparse 两个模型,而 Cloud 则包括 PCC 上的 Cloud、Cloud Pro 以及 Image 模型,负责处理更复杂的任务。
端侧模型的努力
AFM 3 Core Advanced 是一个我很喜欢的端侧模型架构。
但是介绍它之前,我想给大家介绍一下为什么 MoE 在大多数手机、笔记本这样的端侧并不 Work,但对于数据中心 NVLink、以及 NVIDIA GB10、AMD Strix Halo 都很合适的原因。其实最大的限制在于,MoE 仅仅通过稀疏解决了计算量和访存量,但并没有减小访存的 footprint,现在的 MoE 架构都是在每推理一个 Token 时,每个 Layer 都要做 Expert 路由选择。对于云端而言,现在通常是通过上百个 Batch,把调用相同 Expert 的请求聚合在一起,从而把多个 GEMV 变成 GEMM,充分利用硬件的矩阵算力。而对于 NVIDIA GB10、AMD Strix Halo 这样的大容量低带宽的设备,MoE 解决了访存瓶颈和计算带宽,这些设备也有很大的内存容量,因此也是一个很好的方案。
但对于 12GB 内存的 iPhone 这样的设备来说,在我们 1-4B 小模型能力还不足的今天,更大的 MoE 如果全部加载到内存中,虽然有了足够的访存带宽,但是容量根本不够。
因此,Apple 他们有一篇论文提出 Instruction-Following Pruning(IFP)的方法:把 20B 参数的模型放在 NAND 闪存里,每次只把 1–4B 参数换进内存,并且按 prompt 级别而不是 per Token per Layer 做路由。它在 prompt 进来时,用一个300M 的小模型(取最后一个 token 在最后一层的 hidden state)加一个两层 MLP,一次前向算出所有层的 mask(用可微的 SoftTopK 做 top-k),然后把选中的部分放在内存中,推理就类似稠密模型,熟悉 LLM 推理的朋友应该已经很容易想到这种结构的性能优势和性能劣势,它显然比 MoE 路由更难做准。
顺带一提,现在还有另一条路:用 Hierarchical Memory 把超出 GPU VRAM 的超稀疏 MoE 跑起来。Strata 则把内存分为 GPU VRAM / Host DRAM / NVMe 这样的三层 Hierarchy。配合 Qwen3.8-Flash-Next这样的 125B A6B 小型超稀疏 MoE。甚至有更激进的做法是直接跳过不重要 并且 不在 VRAM 中的 Experts,这在 ACL 2024 的一篇工作 里有系统的后训练方法(task-agnostic 与 task-specific 两种)。这些给 MoE 打补丁的做法和 IFP 相比,也许在不同场景下各有优势。
我很欣赏这些从模型本身和推理框架层面让端侧能跑起更强大模型的努力,毕竟端侧模型的进步 = 上云数据的减少,而解决了隐私问题,就更容易推动 AI 更广泛的生活场景落地。
端云路由怎么决定
对 Siri、通知摘要这类系统功能。按 Apple 的 PCC 安全指南,原则是本地优先。一篇逆向分析 也写道:Only if the local models cannot handle a request type is it forwarded to privatecloudcomputed. 但是具体什么才能称为 "cannot handle" 仍然是个黑盒。
PCC 的 TEE
为什么选择 TEE
不同于 FHE 这样目前的数学上最干净但目前性能不现实的方案,TEE (Trusted execution environment) 提供了一条折中的方案:用计算设备里的硬件(比如可能有 CPU 的高特权级内存保护支持,总线保持支持,甚至可能附加专门的安全处理器,例如 AMD PSP)和操作系统之上的高特权级软件实现一块 TEE,即使操作系统不可信也无法访问 TEE 内的内存和计算。这种方法可以获得接近原生的性能,提供足够的安全隔离。通常来说,我们用计算芯片作为 TEE 保护的边界,这是因为数据一旦出了芯片,外部电路可以很容易被物理攻击从而获取敏感信息。而在这个 TEE 内,通常伴随内存加密等技术,以防止物理访问者直接读取敏感数据。
这个时候很多人会好奇,TEE 如何处理 IO 交互问题?其实在有非对称加密的今天很简单:
- 我们可以与 TEE 建立一条非对称加密的通信通道
- 这条通信通道可以用于证明我们访问的是这个 TEE,而不是中间人伪造的环境
- 我们可以在这条通信通道上传输密钥,解开我们的关键密钥,比如磁盘的 LUKS / BitLocker 密钥,确保只有 TEE 内部的软件能访问这些敏感数据。
那么这里就引出了一个很关键的问题,我们如何确认对面跑的真的是我们想要的 TEE,而不是被篡改过的环境?这就是 remote attestation 要解决的核心问题。
Remote Attestation
TEE 保证的是外面看不到里面。比如你去 AWS / 阿里云租个 Intel TDX / AMD SEV 虚拟机,它可以启动一个受保护的执行环境,即使云厂商的管理员也无法直接访问 TEE 内的内存。并且通常需要配合内存加密保证即使物理接触硬件,也无法直接读取 TEE 内的内容。(不过 Encryption 并不保证 Integrity,你可以很容易地利用旧值进行 Hack,这在今天依然是 Challenge,感兴趣的读者可以看 Mountable Merkle Tree 及相关工作)。
但是,一个云厂商完全可以在受保护区域里跑任何它想跑的东西。这个缺口由 remote attestation(远程证明)来补:硬件用自己的私钥,对区域内加载的代码的测量值签名。这样你的设备才能在把数据交出去之前,先验证"对面那台机器跑的是哪一份软件"。
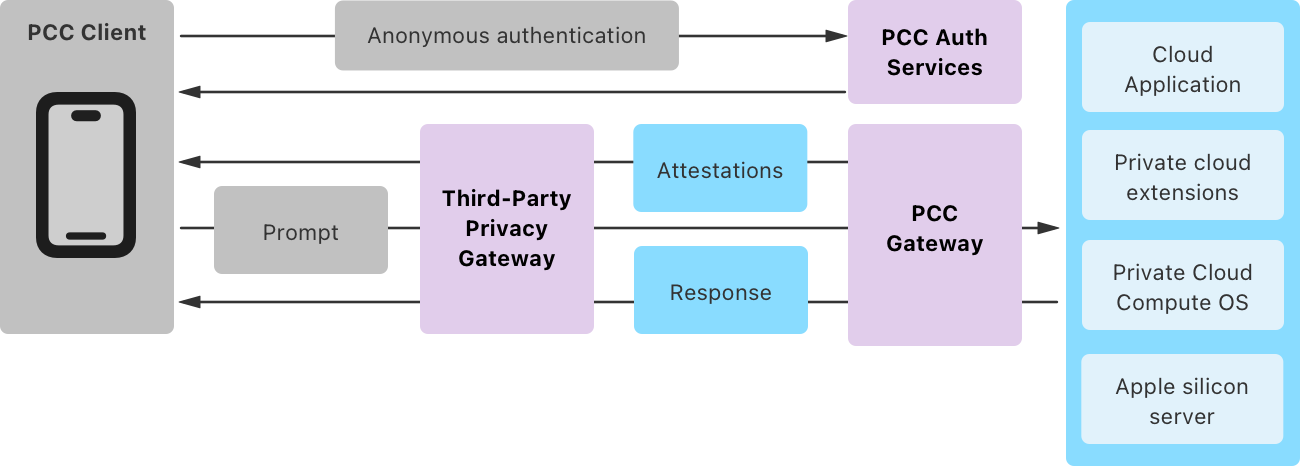
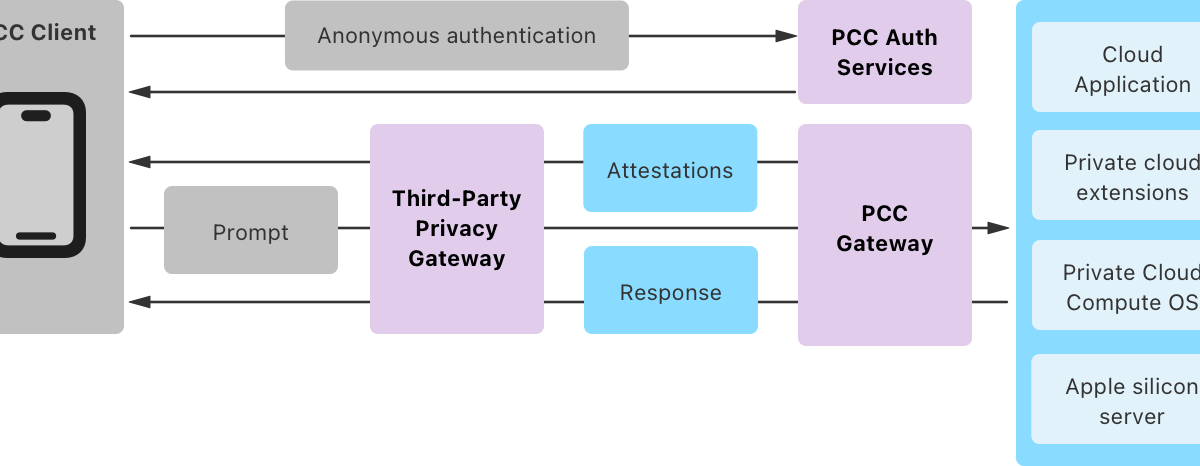
PCC 请求路径概览:PCC Client 先做匿名认证(Anonymous authentication)到 PCC Auth Services;请求(Prompt)经第三方 Privacy Gateway 到 PCC Gateway,再进入 Apple silicon server 上的 PCC OS / Private cloud extensions / Cloud Application;返回路径上是 Attestations 与 Response。来源:Request Flow
因此 TEE 提供隔离,attestation 提供可验证。
对于 TEE,attestation 要做什么?
因此,我们可以思考,对于一个 enclave,remote attestation 要成立,要回答两个问题:
- 我是谁:运行这个 TEE 的到底是哪一颗芯片?
- 我能信任吗:这个 enclave 的启动时状态是否可靠,是否符合预期的硬件和软件状态?
怎么验证
所以一个 remote attestation 通常包含:
- 芯片证明自己的签名能力:由厂商签名的证书私钥,可以由厂商发布的 CA 验证,确保芯片的身份真实性,且保证芯片的密钥不可被读取和篡改。验证过程通常类似我们今天的 TLS,使用 X.509 证书链进行验证。(小思考:Multi-Socket 系统、多卡系统怎么办?NVLink / UPI / IF / PCI-E 等片间互连有没有忘记加密可能? 留给读者思考和跟随 AI 学习。
TEE 内部的测量(measurement)是指安全模块会对需要保护的东西做哈希,再用芯片的私钥签名,形成 attestation,不同类型的 TEE 测量的内容有所不同:
- Enclave 型(如 Intel SGX):测的是这块 enclave 自己的代码与数据,包括宿主进程、OS、hypervisor 全在边界之外。
- 机密虚拟机型(如 AMD SEV、Intel TDX):测的是这个虚拟机启动时的初始状态,包括固件、初始内存(如果你用
qemu -kernel -initrd启动,这部分也可以算作一次轻量级的安全启动)
读到这里许多读者可能会有一个疑问,那 TEE 不是还要信任芯片厂商吗?确实是这样的,因为芯片的私钥是由厂商生成并签发证书的,而 attestation 的签名能力依赖于芯片的私钥。这就意味着,验证方在信任 attestation 的同时,也在信任芯片厂商的根证书和签发能力,以及他们制造的芯片不会出现私钥泄露的情况。
Apple PCC 到底验证了什么
试想一下:如果要把你的私人邮件、信息等等交给云端的 Siri 处理,你希望首先确认什么?
- 它现在跑的是不是 Apple 公开的那一版软件,而且处在留不下我数据的状态?(运维不能临时换版本、或者中途注入新的控制流)
- 上面这些,我能自己核对吗?(而不是只能相信一句声明)
Apple 的 attestation 就是照着这两个问题回答的。在 macOS 上,可以在恢复模式里 csrutil allow-research-guests enable 后,用 /System/Library/SecurityResearch/usr/bin/pccvre release list 列出当前有哪些 release。
$ /System/Library/SecurityResearch/usr/bin/pccvre release list
Showing 10 releases:

  518256: TIE v8 6A378 (downloadable)
    7d659de64d36965812c0521b6e786ddcc48186b9f87b9c1a6177fc14e123925d
  518074: Provenance 6B5062f.1 (seed)
    8ebaa1af50941523b7ff982dec439b54a3dce12031a68506ec08e8dde00de2fc
Note: Google Cloud Storage returned 403 for an availability check; set a token to authenticate: export CLOUDSDK_AUTH_ACCESS_TOKEN=$(gcloud auth print-access-token)
...
我们也可以看它的一个 Release 里有什么,甚至可以下载:
$ /System/Library/SecurityResearch/usr/bin/pccvre release dump -R 518256
  518256: TIE v8 6A378 (downloadable)
    7d659de64d36965812c0521b6e786ddcc48186b9f87b9c1a6177fc14e123925d

Application: TIE v8
Build version: 6A378
Inserted: 2026-10-12T23:04:17
Expires:  2026-10-26T23:04:17
Tickets:
      OS: 21ffbbea04ace44b8698265669af41c8d78560ca06ba655260b015e56199ae47
    Cryptexes
    Code: 83236f2ae188cd64858098616b935f852fbe2550b4a4dee6ca72cedcd599020c
    Data: 13a995dd95278186bab54fbb6b2fc63b52d08945fe945fba262b88341f5bd94f
...
Apple 官网也给出了 PCC 的软件结构图。
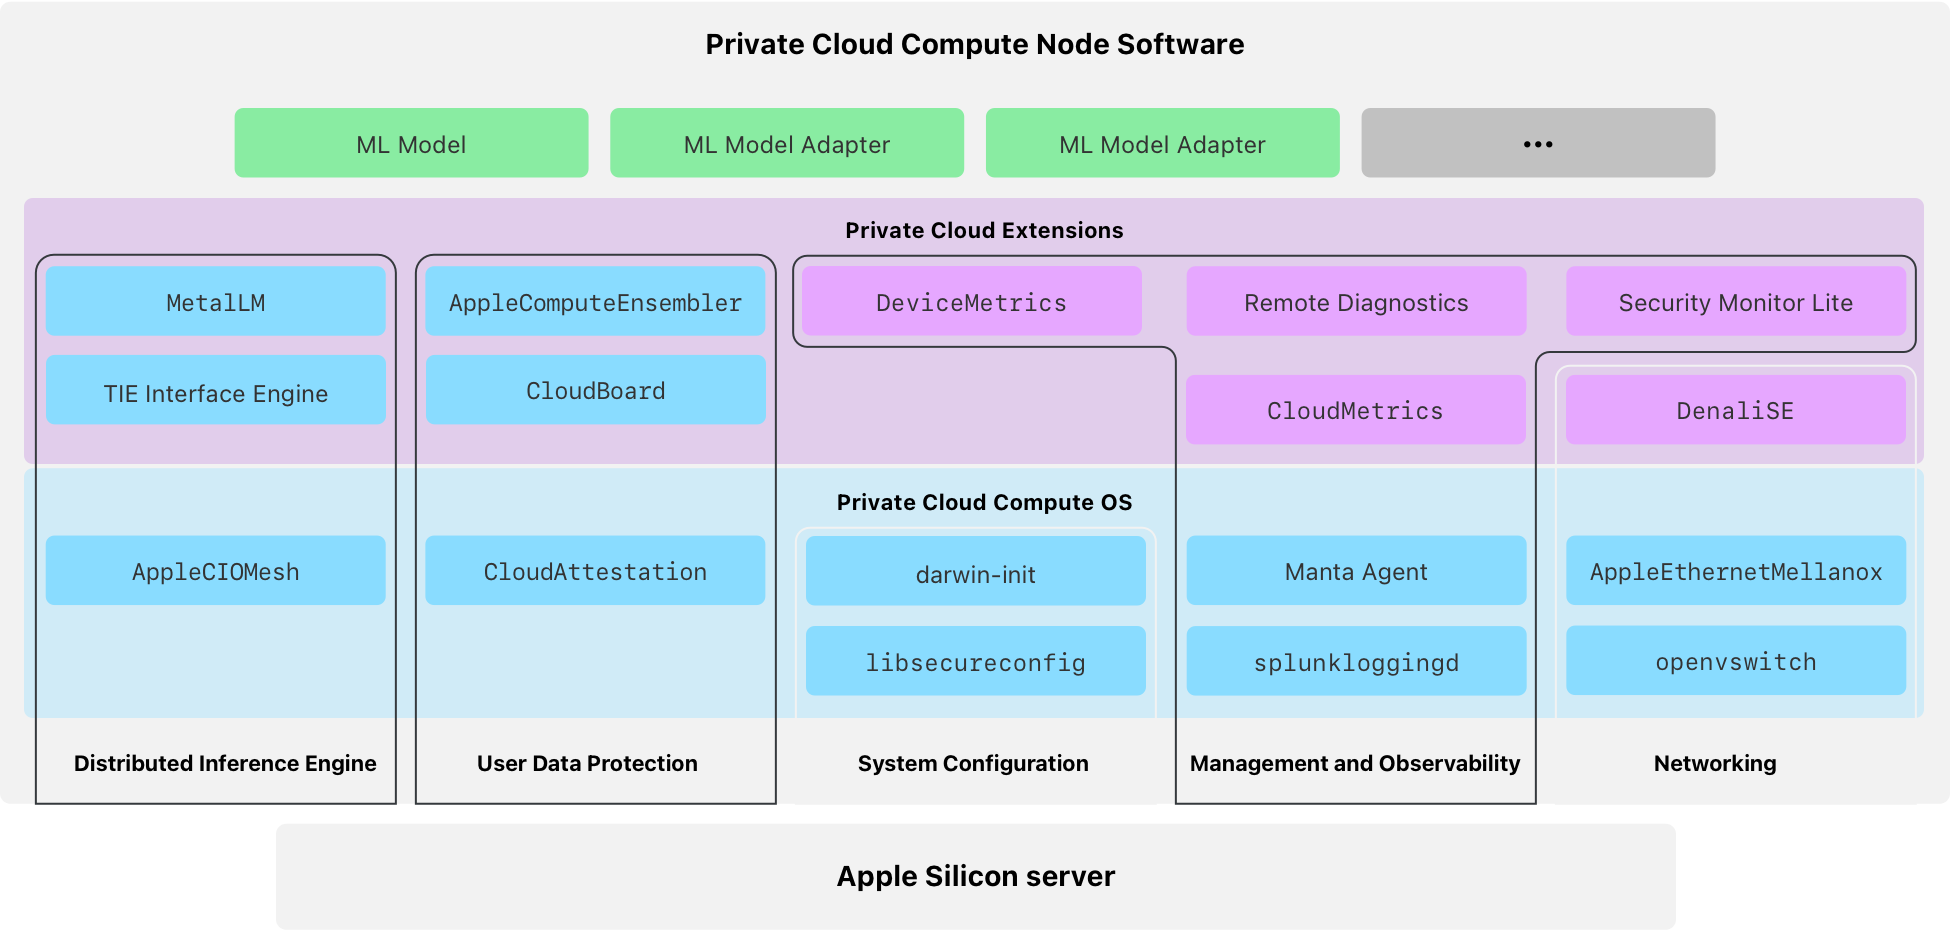
那么哪些发、哪些不发?这张图里其实没有答案,得看 Apple 的文字说明。
模型与 adapter 不发布,只公布 Hash:
Foundation model and adapter cryptexes: "Although the model and adapter cryptexes are measured and attested to like standard cryptexes, they are considered proprietary and not published as part of our transparency commitment."
Inspecting Releases: ""the software components are published while the model/adapter images will not be.""
把这些对应到 release 里,是按"包"登记的:Code(可下载、可复现测量值、可反汇编)、 Data 是数据,再加上图里没有画出的一份 OS 清单(包括 iBoot、内核、监控层等系统与固件)与每个可执行文件的 CDHash。
另外,这套二进制里没有"代码执行"能力,只有"执行预定义动作"的能力。
PCC 节点上所有能动态执行代码的机制都被刻意删掉了。Apple 的原话是:"To allow comprehensive analysis of the software running on PCC nodes, we disable or remove mechanisms to execute code dynamically, including:""
- System shells (e.g.
zsh) - Interpreters (e.g.
JavaScriptCore) - Debuggers (e.g.
debugserver) - Just-In-Time (JIT) compiler functionality"
而代码执行策略由一个独立于内核的监控层(TXM)来强制:
"The TXM enforces several restrictive policies on PCC nodes to ensure that only known code can execute:""
- All code must be covered by a trust cache.
- JIT mappings cannot be created.
- Developer Mode cannot be enabled.
- Debugging workflows are not supported."
也就是说云端没有 Python 沙箱、没有 JS 引擎、不能 eval、不能动态加载库;能被执行的指令集合,被硬件锁死在这次启动加载的那份二进制里。
那云端 Agent 怎么办呢?阅读 PPC Agent 和 Multi-Turn Agent 后你会发现,它依赖于预定义的动作,所有能执行的操作都在编译进二进制的表里,无法在运行时扩展。外部工具的调用通过 JSON-RPC 协议进行,服务端对调用次数有限制,防止滥用。当模型请求一个 PCC Agent 没实现的工具时,请求会被送回设备本地执行。
所以,我们再来看,整个 attestation 怎么做,Apple 给出了答案:
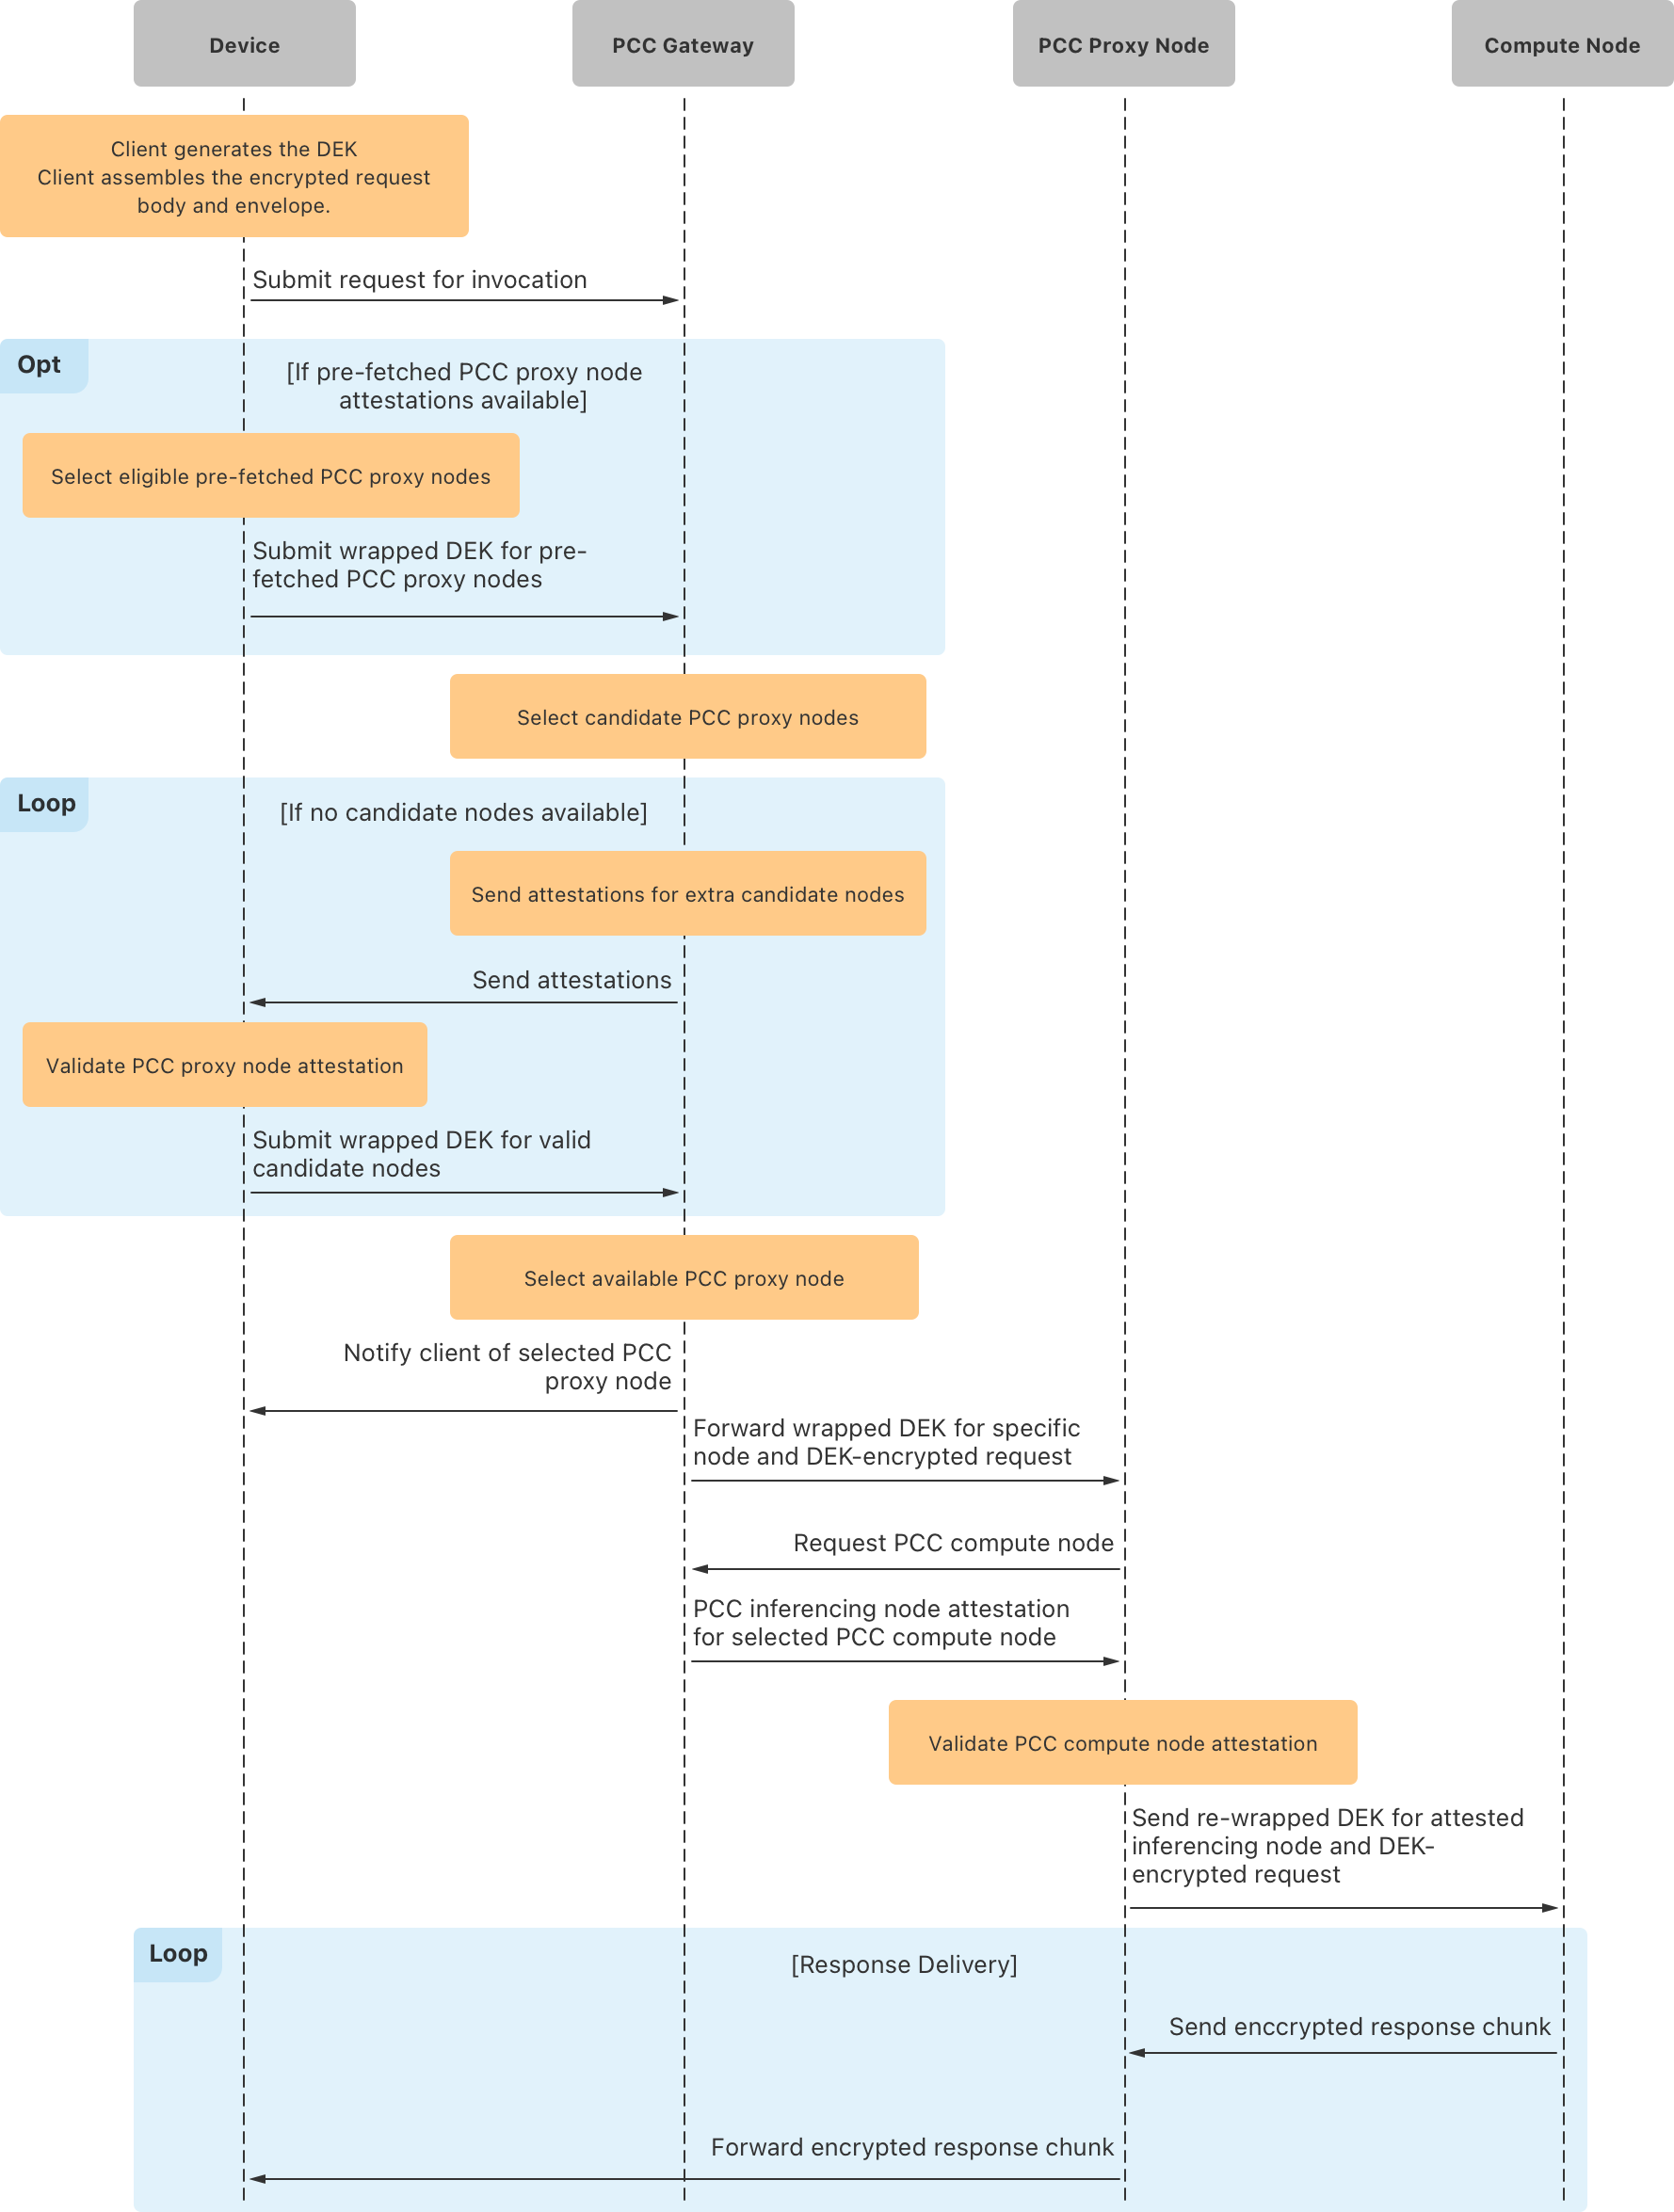
推理中,KV Cache 加密怎么处理的?
我们知道,LLM 推理分为 Prefill 和 Decode,Prefill 是将已有的输入上下文构建成 KV Cache(Apple 对这两个阶段的描述)。我们在聊天窗口继续提问时,也是在我们的上下文继续追加,从而可以有相同的前缀,进而复用之前的 KV Cache,避免重复计算 Prefill。
因此,KV Cache 的管理就成了 PCC 需要解决的核心问题。而 PCC 的解法是按照 KV Cache 会存放的位置分层处理。
我让 AI 帮我总结了一下:
(先把三个密钥名字顺一下:DEK 是你的设备每请求生成的对称密钥;REK 是节点启动时生成的、SEP 保护的密钥对,一把 REK 覆盖许多请求;KVDEK 不是独立密钥,而是从 DEK 派生出来、专门用于搬运 KV cache 的。三者的关系在下一节展开。)
| KV cache 在哪 | 怎么保护 | 出处 |
|---|---|---|
| 1. 正在计算的那块内存里 | 文档在这里给的不是密码学保证,而是进程隔离 + 定期回收:数据在"bounded in time"内被清除,而不是每次请求后立即擦除;而且 Apple 明确说"certain aspects of data lifecycle depend on Swift memory management and the behavior of the system allocator"。这是四层里最弱的一环 | Anticipating Attacks |
| 2. 节点之间传输时(ensemble 内部逐层交换) | AppleCIOMesh 对 USB4 和以太网上的所有数据用 AES-GCM 128 加密,每个节点一把独立密钥,由 leader 的主种子经 HKDF-SHA384 派生;防重放是 64 位随机 + 32 位隐式计数器,计数器用尽、解密失败或链路断开都算灾难性故障——整个 ensemble 下线重启 |
Stateless Inference |
| 3. 跨 ensemble 交接时(prefill → decode) | 从设备给的 DEK 派生出 KVDEK(HKDF-SHA256 + 固定标签)。因为它是 DEK 的确定性函数,每个处理该请求的 ensemble 都能各自算出来,不需要交换任何密钥材料——于是"只有拿得到原始 DEK 的 ensemble 才解得开" | Stateless Inference |
| 4. 留在盘上等待复用(多轮对话) | 设备每轮生成一把新的 256-bit AES 密钥送上来(同时附上之前还需要复用的那些轮次的密钥)。服务端不留任何密钥——原话:"PCC retains no KV cache encryption keys between turns… the encrypted blobs that remain are not decryptable by any process on the node without the device resupplying the relevant key" | Stateless Inference |
也就是说:PCC 想继续复用这些数据,需要你的设备每次都重新提供相应的密钥。
那 batching 呢?attestation 是怎么被摊薄的
在线 LLM 推理要有好效果就得把多个请求组成 batch,那 attestation 怎么办?
Apple 给的答案是:attestation 不是"按请求"的,而是"按节点 / 按 epoch"的。 节点侧是这么起的(原文):"CloudBoard begins by creating a SEP-protected Request Encryption Key (REK) pair, to which user devices encrypt requests. Then, it uses the CloudAttestation framework to assemble an attestation bundle for this key pair."
我让AI 帮我总结了一下:
节点启动(及周期性刷新)
  └→ 生成 Request Encryption Key(REK)+ 组装 attestation bundle
       └→ 这份 attestation 绑定的是这个 REK,而一个 REK 服务许多请求

每个请求
  └→ 客户端生成 Data Encryption Key(DEK)
       └→ 用 HPKE wrap 到那个「已通过验证」的 REK   ← 这一步才是重点
("服务许多请求"是个组合推断:REK 在节点启动时创建,而按文档它只在透明度日志的未过期 release 集合变化时才换一把——所以它天然跨请求复用。)
三个细节:
| 机制 | 数值 | 意义 | 出处 |
|---|---|---|---|
| 客户端预取并缓存的 attestation | ≥ 40 份,每次请求随机用 ≤ 2 份 | 不需要每请求都去取 | Attested Request Handling |
| 客户端验证时要求的最低剩余有效期 | ≥ 1 天(源码默认下限 .days(1)) |
通过一次,接下来一段时间都不必重验 | NodeValidator.swift |
| REK 及其 attestation 的刷新时机 | 只在透明度日志的未过期 release 集合变化时 | 慢节奏,不是每请求 | Transitive Trust |
所以对单个请求来说,预取 attestation 可以避免每次都进行额外的网络 RTT。
那么,attestation 能被欺骗吗
如果 Apple 的方案是使用 Intel / AMD / NVIDIA 的类似功能,attestation 的安全性依赖于这些硬件提供的可信执行环境,但是引入了相对可靠的第三方,我认为是可靠的。
但是,Apple 目前的方案是完全依赖自家的硬件和软件栈来实现 attestation,而且芯片本身是否预留调试接口,BootROM 是否安全,这些都是外部无法验证的因素。Apple 完全有能力自己去造一个芯片后门,或者自己根据自己的 TEE 设计让你通过 attestation 验证,因为密钥都是他们自己发的。
所以我的结论是,比没有更好,但是严格来说,威胁模型没有改变:你依然需要信任 Apple。
假设 TEE 可靠,TEE 内部的软件安全吗?
我这个担心,Apple 显然也知道。它给出的回答是:把源码和二进制公开出来,然后出钱请人来打。
2024 年 10 月,Apple 把 PCC 的 Security Guide、部分源码和研究环境一起开放,同时宣布把 Apple Security Bounty 扩展到 PCC(公告原文):"Today we're making these resources publicly available to invite all security and privacy researchers — or anyone with interest and a technical curiosity — to learn more about PCC and perform their own independent verification of our claims."
价码给到了 iOS 级别,Apple 的说法是 "the rewards we offer are comparable to those for iOS"。按悬赏类别页:
| 漏洞类别 | 最高悬赏 |
|---|---|
| 远程攻击请求数据,最终在 PCC 软件镜像内实现任意 entitlement 的未签名代码执行 | $1,000,000 |
| 在信任边界外拿到用户的请求数据、或关于用户请求的敏感信息 | $250,000 |
| 在特权网络位置下做同样的事 | $150,000 |
| 在 PCC 软件栈里执行未通过 attestation 的代码 | $100,000 |
| 部署 / 配置失误导致的意外数据泄露 | $50,000 |
公告里还留了个口子:"we will consider any security issue that has a significant impact to PCC for an Apple Security Bounty reward, even if it doesn't match a published category"。
2026:PCC 扩展到了 Google Cloud
因为 AFM 3 Cloud Pro 这类最重的 agentic 负载需要 NVIDIA GPU,Apple 把 PCC 扩到了 Google Cloud。技术栈是三层硬件信任的叠加:NVIDIA Blackwell GPU Confidential Computing + Intel TDX(CPU 侧 TEE)+ Google Titan 芯片(信任根),感兴趣的朋友可以看 Apple 的博客。
不过很显然,Google Cloud 上的信任根比 Apple Silicon 上要复杂得多,涉及到 Intel CPU 和 NVIDIA GPU,以及 Google 自己的 Titan 芯片。 Apple 的 PCC 安全指南 至今(2026年10月13日)没有 Google Cloud 的技术细节。所以具体怎么做的,我们等待后续的官方披露。
但我觉得,引入第三方硬件和信任根,虽然增加了系统的复杂性,但也可能带来更高的安全性和更强的抗攻击能力。因为这就让我们不仅仅依赖单一厂商的硬件信任,而是形成了多层次、多来源的安全保障。
总结
从 Apple PCC 的设计,可以看出 Apple 对数据隐私和安全的重视。通过多层硬件信任、节点侧加解密以及 attestation 机制,PCC 在保证计算能力的同时,尽量减少了对明文数据的暴露。
但与其他 TEE 一样,它依然依赖我们对硬件厂商的信任,任何一个接触的明文的环节引入了调试接口、软硬件后门,都可能让整个系统不再可信。但至少,我们看到了 Apple 的态度,以及他们开放二进制给我们审查,以及持续改进安全性的努力。
我很希望以后看到越来越多重视隐私的 AI 服务出现,让用户在享受强大 AI 能力的同时,也能更好地保护自己的隐私安全。